WM-811K 웨이퍼 결함 분류
분류 난이도와 희소성에 따라 클래스별 증강량을 다르게 배분해, 결함을 놓치지 않는 성능(Recall)을 높인 프로젝트
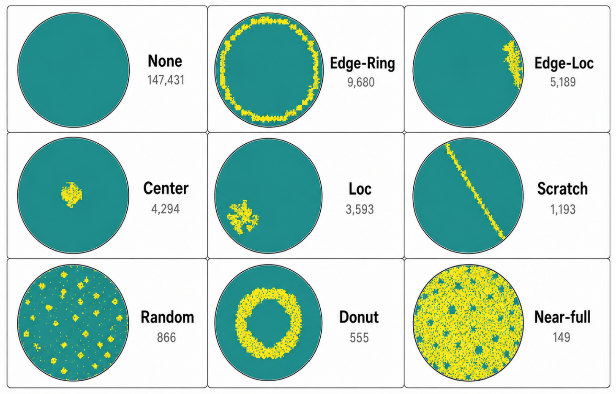
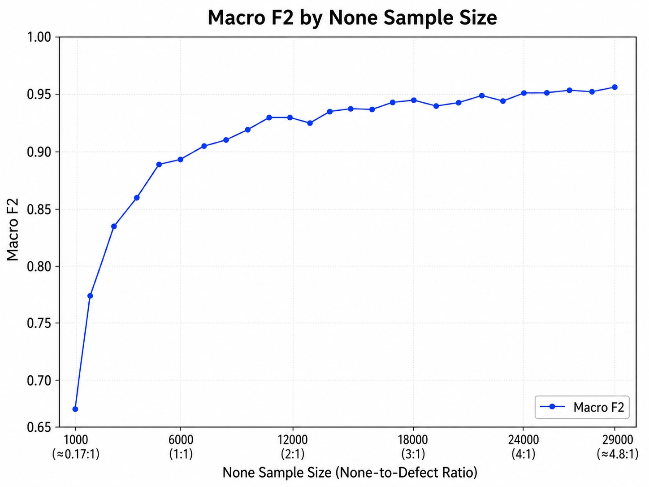
WM-811K 웨이퍼 맵은 정상(None)이 약 85.2%를 차지하고, 결함 클래스끼리도 Edge-Ring 9,680장과 Near-full 149장처럼 차이가 큽니다. 모든 결함 클래스에 같은 양을 증강하면 클래스마다 다른 부족함과 분류 난이도를 반영하지 못해서, 정해진 증강 예산을 어떻게 나눌지에 집중했습니다.
- 기간
- 2026년 1학기
- 인원
- 2명
- 내 역할
- 데이터 전처리, 증강, 모델 학습과 튜닝 (공동 수행)
기술 스택
- Python
- PyTorch
- MobileNetV2
아키텍처
내가 한 일
- WM-811K에서 라벨이 있는 데이터를 추출해 64×64, 3채널로 전처리하고, 5개 fold로 나눠 fold 0을 고정 테스트셋으로 썼습니다.
- 회전과 반전 기반의 전통적 증강으로 균등 증강 데이터셋과 차등 증강 데이터셋을 만들었습니다.
- ImageNet 사전학습 MobileNetV2를 전이학습하고, 검증 Macro-F2를 기준으로 모델을 선정했습니다.
- 하이퍼파라미터(AdamW, learning rate, weight decay 1e-4)를 튜닝하고 클래스별 증강 가중치를 조정하며 실험했습니다.
- 최종 보고서를 작성했습니다.
팀 맥락
2명이서 대부분의 실험을 함께 했습니다. 정상과 결함의 기준 비율 탐색과 증강 가중치 수식은 팀원이 주도했고, 전처리부터 증강, 학습, 튜닝, 가중치 조정까지는 함께 했습니다.
설계 결정
연구 질문 전환
- 결정
- 증강량 배분 전략을 비교하는 쪽으로 바꿨습니다.
- 근거와 한계
- 기법 간 성능 차이가 크지 않아 단순 비교로는 불균형 문제를 어떻게 풀었는지 보여 주기 어렵다는 지도교수님 피드백을 반영했습니다.
모델 선정 기준
- 결정
- Macro-F2로 바꾸고 Defect Macro-F2를 핵심 지표로 정했습니다.
- 근거와 한계
- 결함을 놓치지 않는 것(Recall)이 중요한 문제라서, Recall에 더 큰 비중을 두는 F2가 목적에 맞았습니다.
클래스별 증강량 배분
펼쳐 보기
| 클래스 | 검증 F2 | 난이도 D | 희소성 | 최종 가중치 | 증강량 |
|---|---|---|---|---|---|
| Scratch | 0.5802 | 0.4198 | 0.5022 | 0.4830 | 1,130 |
| Loc | 0.6351 | 0.3649 | 0.2378 | 0.3910 | 915 |
| Edge-Loc | 0.7450 | 0.2550 | 0.1496 | 0.2665 | 624 |
| Donut | 0.8175 | 0.1825 | 0.6860 | 0.2201 | 515 |
| Random | 0.8790 | 0.1210 | 0.5795 | 0.1421 | 333 |
| Center | 0.8950 | 0.1050 | 0.1951 | 0.1111 | 260 |
| Near-full | 0.9425 | 0.0575 | 1.0000 | 0.0747 | 175 |
| Edge-Ring | 0.9672 | 0.0328 | 0.0000 | 0.0328 | 77 |
분류가 어려운 Scratch와 Loc에 증강량이 가장 많이 배분되고, 이미 잘 분류되는 Edge-Ring에는 적게 배분됩니다.
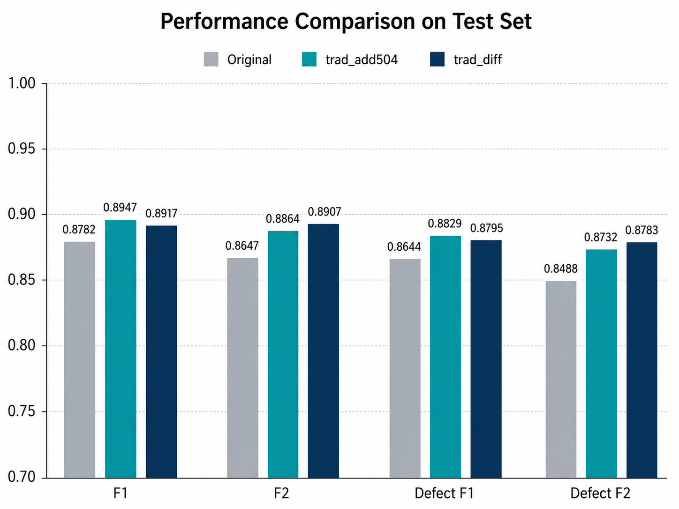
최종 성능 비교 (fold 0 고정 테스트셋)
| 조건 | Macro-F1 | Macro-F2 | Defect Macro-F1 | Defect Macro-F2 |
|---|---|---|---|---|
| 원본 | 0.8782 | 0.8647 | 0.8644 | 0.8488 |
| 균등 증강 | 0.8947 | 0.8864 | 0.8829 | 0.8732 |
| 차등 증강 (제안) | 0.8917 | 0.8907 | 0.8795 | 0.8783 |
차등 증강은 F2 계열 지표에서 가장 높았고, F1 계열은 균등 증강이 조금 더 높았습니다.
증강량 배분 수식
펼쳐 보기
python
difficulty = 1 - f2_score                    # 분류 난이도 (검증셋 F2 기준)
scarcity = math.log(n_max / n_class)         # 희소성 보너스 (데이터가 적을수록 큼)
weight = difficulty * (1 + 0.3 * scarcity)   # 최종 가중치
aug_count = budget * weight / total_weight # 증강 예산 4,024장을 가중치 비율로 배분결과
- Macro-F2
- 0.8647 → 0.8907
- Defect Macro-F2
- 0.8488 → 0.8783
- Scratch F2
- 0.6356 → 0.7553
- 증강 예산
- 4,024장
배운 점
- 불균형 데이터에서는 Accuracy 하나로 판단할 수 없어서, 문제 목적에 맞는 평가 지표를 먼저 정해야 한다는 것을 배웠습니다.
- 모델 구조만큼이나 학습 데이터의 구성과 배분이 성능에 큰 영향을 준다는 것을 실험으로 확인했습니다.
한계
- 희소성 계수 0.3 등 난이도 계산 수식이 휴리스틱이라 통계적 근거가 부족합니다.
- Macro-F1은 균등 증강이 더 높았고, Donut, Random, Near-full은 차등 증강에서 오히려 점수가 낮아 모든 클래스가 고르게 개선되지는 않았습니다.
- 공개 데이터셋(WM-811K)만 사용해서 실제 생산라인 데이터로는 검증하지 못했습니다.
다음 개선 과제
- 결함 패턴의 형태에 맞춰 클래스별 증강 기법과 증강량을 따로 정하기
- 난이도 산정 기준이 객관적인지, 다른 도메인에도 일반화되는지 검증하기